
Enlace pagado de Amazon. En calidad de Afiliado de Amazon, Pangea IA obtiene ingresos por las compras adscritas que cumplen los requisitos aplicables, sin coste adicional para ti.
Por Redacción Pangea IA · 14 de septiembre de 2026
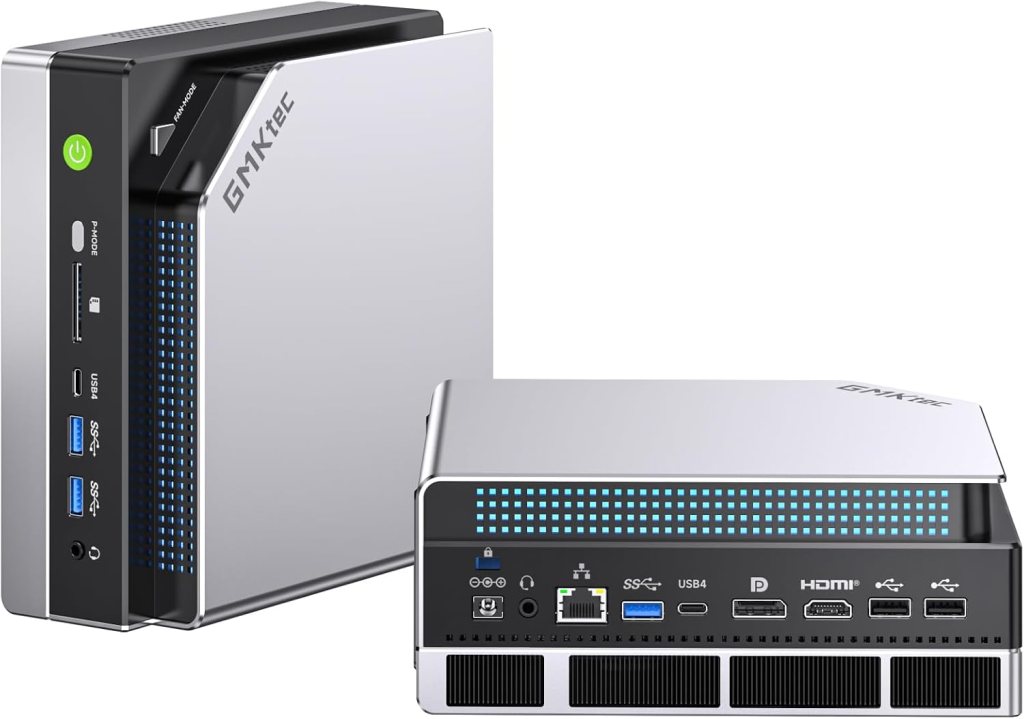
El GMKtec EVO-X2 con 64 GB de RAM y SSD de 2 TB es una opción compacta para quien quiere ejecutar modelos de IA en su propio ordenador. Su principal atractivo para este uso es el margen de memoria: permite plantearse modelos más grandes que los que elegiríamos para un equipo de 24 GB. La velocidad dependerá del modelo, su configuración y la aceleración que utilice el programa.
Esta ficha se basa en documentación del fabricante y en la configuración anunciada en Amazon. No hemos probado físicamente el equipo ni medido sus respuestas por segundo. Lo incluimos como la opción con más memoria en nuestra comparativa de Qwen, Gemma y Nemotron para IA en local.
La configuración que hemos seleccionado
El enlace de compra corresponde al GMKtec EVO-X2 con AMD Ryzen AI Max+ 395, 64 GB de RAM y SSD de 2 TB anunciado en esta ficha de Amazon. Existen otras capacidades dentro de la familia EVO-X2; comprueba que la variante seleccionada conserve estos 64 GB y 2 TB al realizar el pedido.
El fabricante especifica un procesador de 16 núcleos y 32 hilos, gráficos integrados Radeon 8060S y memoria LPDDR5X de 8.000 MT/s. La RAM está integrada y no es ampliable. Especificaciones y variantes oficiales del EVO-X2.
Los 64 GB de RAM y los 2 TB de SSD cumplen funciones distintas. La memoria permite mantener el modelo y los datos de trabajo cargados; el SSD guarda descargas, programas y documentos. Tener mucho almacenamiento no sustituye la RAM que necesita un modelo para funcionar.
Qué modelos de IA plantearíamos para este PC
Empezaríamos por las mismas versiones cuantizadas que hemos elegido en la comparativa. Estas descargas reducen el tamaño de los pesos respecto a las versiones de mayor precisión.
| Modelo y descarga de referencia | Tamaño Q4_K_M | Uso que probaríamos |
|---|---|---|
| Qwen3.5-9B | 5,63 GB | Resúmenes, redacción y ayuda general. |
| Gemma 3 12B IT | 7,3 GB | Preguntas sobre textos e imágenes, si el programa admite visión. |
| Nemotron 3 Nano 30B-A3B | 24,6 GB | Razonamiento y proyectos de programación. |
Los tamaños enlazados corresponden a archivos de modelos, no al consumo total de RAM. El sistema, la aplicación, el contexto de la conversación y los componentes visuales también necesitan memoria. Nuestra propuesta supone un modelo cargado cada vez y un contexto inicial moderado, por ejemplo de 4.000–8.000 tokens; es una orientación de configuración, no una medición de rendimiento.
Los 64 GB ofrecen más margen para la descarga de Nemotron citada, pero no deben interpretarse como 64 GB de memoria gráfica exclusiva. El sistema y los gráficos comparten recursos. Tampoco garantizan que cualquier modelo grande funcione con fluidez.
Cómo empezar y qué comprobar
Una ruta sencilla es instalar LM Studio, descargar un motor compatible y cargar primero Qwen o Gemma. Revisa los requisitos de LM Studio y utiliza controladores y un motor que admitan la Radeon del equipo. Comprueba dentro del programa si utiliza aceleración gráfica o está ejecutando el trabajo en CPU.
La etiqueta «AI PC» y las cifras comerciales de potencia no indican por sí solas la velocidad de un chat local. Tampoco implican que cualquier aplicación vaya a utilizar automáticamente la NPU. Prueba una conversación corta antes de ampliar el contexto o añadir documentos grandes.
Para valorar el resultado, utiliza un texto que conozcas: pide un resumen, preguntas sobre datos presentes y una pregunta cuya respuesta falte. Revisa si inventa información y cuánto tarda. Un modelo local sigue necesitando supervisión.
¿Permite usar IA sin pagar tokens?
Sí, cuando ejecutas el modelo descargado en el propio ordenador, esas consultas no generan una factura de API. Según su documentación, LM Studio permite conversar y trabajar con documentos sin conexión una vez descargados el modelo y los componentes necesarios. Funciones sin conexión de LM Studio.
Sigues pagando el equipo y la electricidad. Si conectas una API o un servicio externo, sus posibles cargos son independientes. Comprar un PC únicamente para sustituir una suscripción exige comparar el coste con el uso real que vas a darle.
Para quién lo elegiríamos
Lo valoraríamos para quien necesita un ordenador compacto con bastante memoria y quiere experimentar con modelos locales, especialmente con Nemotron en la versión citada. Para empezar con Qwen o Gemma, probaríamos antes el equipo que ya tienes.
Si prefieres macOS y tus necesidades encajan en modelos más pequeños, puedes consultar el Mac mini M5 Pro de 24 GB. No recomendamos esa capacidad para la descarga de Nemotron de 24,6 GB. La comparativa completa de IA en local explica los límites de ambas propuestas.
Dónde comprar el GMKtec EVO-X2 de 64 GB y 2 TB
Consulta el precio y la disponibilidad actuales en Amazon y comprueba la variante de 64 GB de RAM y SSD de 2 TB, el vendedor y el importe final. Si necesitas monitor, teclado o ratón, inclúyelos en tu presupuesto.
Enlace pagado de Amazon. En calidad de Afiliado de Amazon, Pangea IA obtiene ingresos por las compras adscritas que cumplen los requisitos aplicables, sin coste adicional para ti.
Imagen del producto: ficha de Amazon del GMKtec EVO-X2. Información consultada el 14 de septiembre de 2026.


Deja una respuesta