
Por Redacción Pangea IA · 7 de octubre de 2026
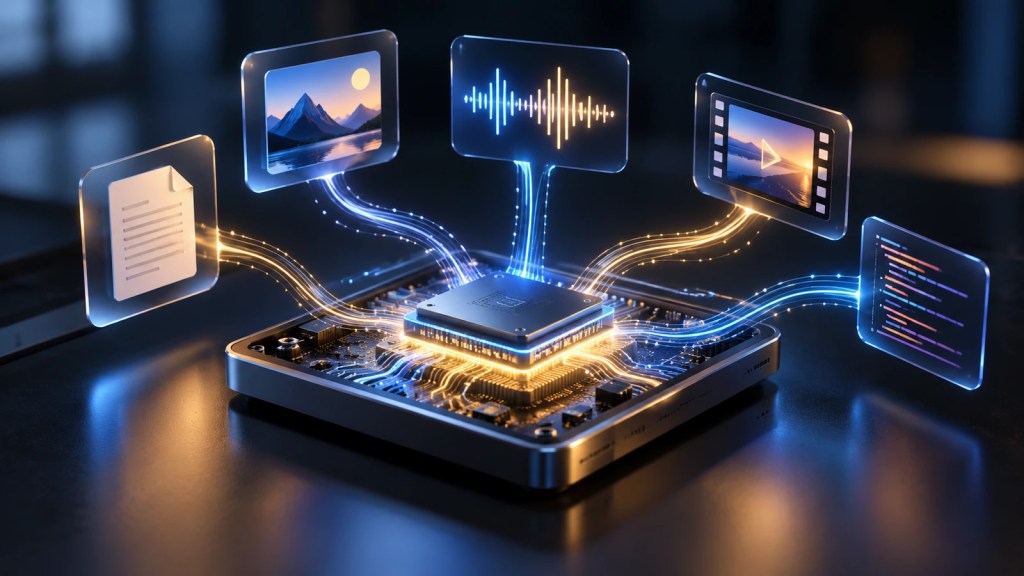
Google DeepMind ha presentado EmbeddingGemma 2, un modelo abierto de 740 millones de parámetros diseñado para convertir texto, código, imágenes, vídeo y audio en representaciones numéricas comparables dentro de un mismo espacio. La novedad no busca competir con un chatbot: su función es permitir que aplicaciones encuentren, relacionen y clasifiquen información multimodal, incluso directamente en móviles y ordenadores y sin enviar necesariamente los datos a la nube.
Qué es EmbeddingGemma 2 y por qué importa
Un modelo de embeddings transforma contenido en vectores: listas de números que representan su significado. Si dos elementos son semánticamente parecidos, sus vectores quedan próximos. Esto permite, por ejemplo, buscar una fotografía escribiendo una descripción, localizar un momento de un vídeo mediante una consulta de voz o encontrar un fragmento de código a partir de una pregunta en lenguaje natural.
EmbeddingGemma 2 lleva esa idea a varias modalidades a la vez. Según Google DeepMind, texto y código, imágenes, vídeo y audio se proyectan en un espacio unificado de 768 dimensiones. Esto evita tener que encadenar necesariamente varios modelos especializados para convertir audio a texto, describir imágenes y generar después embeddings textuales.
El enfoque encaja con una tendencia que ya analizamos en Pangea IA: ejecutar más inteligencia artificial cerca del usuario. En nuestra comparativa de Qwen, Gemma y Nemotron para IA local explicamos las ventajas y límites de procesar modelos sin depender continuamente de servicios remotos. EmbeddingGemma 2 aborda una pieza distinta del problema: la búsqueda y recuperación de información.
740 millones de parámetros, pero con arquitectura modular
El modelo completo suma 740 millones de parámetros. La arquitectura es modular: el componente de texto utiliza 270 millones, el codificador visual añade 170 millones y el de audio otros 300 millones. Un desarrollador que solo necesite texto y código puede prescindir de los módulos visual y de audio y reducir así el consumo de recursos.
Google afirma que una versión cuantizada necesita aproximadamente 191 MB de RAM activa para los pesos de texto y unos 567 MB para el modelo multimodal completo en un Pixel 11 Pro. Son cifras obtenidas por la propia compañía en su hardware y configuración, por lo que no deben interpretarse como un consumo garantizado en cualquier dispositivo. Aun así, ilustran el objetivo: hacer viable este tipo de búsqueda en equipos de consumo.
El contexto alcanza 8.192 tokens. Google indica que puede procesar hasta unos 5,5 minutos de audio, 29 imágenes o 58 fotogramas de vídeo, además de combinaciones intercaladas. Para las salidas utiliza embeddings de 768 dimensiones, aunque incorpora Matryoshka Representation Learning para reducirlos a 512, 256 o 128 dimensiones cuando el desarrollador prioriza almacenamiento y velocidad.
Qué se puede hacer con esta IA en un móvil u ordenador
La aplicación más inmediata es la búsqueda semántica local. Una fototeca podría localizar imágenes por su contenido sin que el usuario hubiera añadido etiquetas manualmente. Un archivo de reuniones podría buscar segmentos de audio mediante una frase. Y una aplicación de vídeo podría encontrar escenas concretas a partir de texto o incluso de una nota de voz.
También puede actuar como capa de recuperación para sistemas RAG. En vez de enviar todo un conjunto de documentos, imágenes o grabaciones a un servidor, una aplicación puede indexarlos localmente, recuperar únicamente los elementos relevantes y entregar después ese contexto a un modelo generativo. Google propone combinar EmbeddingGemma 2 con Gemma 4, con el que comparte componentes de arquitectura.
Otra posibilidad es la clasificación sin entrenamiento específico. Una aplicación puede comparar una entrada con descripciones de categorías y determinar cuál es semánticamente más próxima. Google AI Edge plantea este mecanismo para enrutamiento de intenciones y motores de decisión de baja latencia.
Privacidad y funcionamiento sin conexión
El procesamiento local tiene una consecuencia especialmente relevante para empresas: los datos pueden permanecer en el dispositivo. Esto no convierte automáticamente cualquier aplicación que utilice EmbeddingGemma 2 en privada o segura —dependerá del software completo, su configuración y de qué otros servicios utilice—, pero sí permite construir flujos de búsqueda y recuperación que no necesitan enviar cada consulta o documento a una API externa.
Ese enfoque puede resultar útil para notas internas, documentación técnica, archivos audiovisuales o bases de conocimiento que una organización no quiera sacar de su infraestructura. Es una lógica similar a la que vimos al analizar Altar-1 y la ejecución local en ciberseguridad: mantener el procesamiento cerca de los datos puede reducir exposición, aunque no elimina por sí solo los requisitos de seguridad, gobierno y cumplimiento.
Qué significa para pymes y autónomos
Para una pyme, el interés no está tanto en entrenar un modelo desde cero como en integrarlo en aplicaciones concretas. Un catálogo de productos podría admitir búsquedas por descripción o imagen; un estudio audiovisual podría indexar su archivo; un despacho podría crear una búsqueda semántica sobre documentación interna; y un equipo de desarrollo podría indexar código para localizar funciones relacionadas por significado.
La licencia Apache 2.0 facilita usos comerciales, aunque cualquier implantación real debe revisar además las licencias de las herramientas, datos y componentes que rodeen al modelo. Los pesos están disponibles a través de Hugging Face y Kaggle, y Google documenta compatibilidad con herramientas como transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama y LM Studio.
Para empresas de España y la Unión Europea, ejecutar localmente puede ayudar a diseñar arquitecturas con mayor control sobre los datos, pero no sustituye las obligaciones aplicables de protección de datos o del Reglamento de IA cuando correspondan. La ubicación del cálculo es una decisión técnica; el cumplimiento depende del caso de uso completo.
Lo que Google afirma y lo que todavía debe demostrarse
Google presenta EmbeddingGemma 2 como líder entre modelos multimodales de embeddings de menos de 1.000 millones de parámetros en varios benchmarks. También informa de una mejora notable en tareas de código: 78,68 puntos en MTEB Code frente a 68,76 de la generación anterior. Estas comparaciones proceden de evaluaciones publicadas por Google y conviene tratarlas como resultados de benchmark, no como garantía de que el modelo sea superior en cada aplicación real.
El rendimiento dependerá del idioma, del tipo de datos, del dispositivo, de la cuantización y de cómo se construya el índice vectorial. El propio diseño Matryoshka implica además un intercambio: reducir las dimensiones ahorra almacenamiento y acelera búsquedas, pero puede sacrificar parte de la calidad. La elección adecuada tendrá que medirse sobre los datos de cada proyecto.
Una pieza menos visible de la próxima IA local
Los modelos generativos suelen concentrar la atención porque producen texto, imágenes o código. Sin embargo, una parte esencial de los futuros asistentes será encontrar el dato correcto antes de razonar sobre él. Si un dispositivo puede entender semánticamente documentos, fotografías, grabaciones y vídeos sin subirlos primero a un servidor, la búsqueda local puede convertirse en una capa básica de nuevas aplicaciones personales y empresariales.
EmbeddingGemma 2 es relevante precisamente por eso. No pretende ser el asistente final, sino el componente que ayuda a decidir qué información es relevante. Su tamaño, modularidad y licencia reducen barreras para experimentar con esa función en hardware convencional. Queda por comprobar cómo se comporta fuera de los benchmarks y en conjuntos de datos reales, especialmente en distintos idiomas y dispositivos.
Lecturas relacionadas
Fuentes consultadas
- Google DeepMind: anuncio oficial de EmbeddingGemma 2, publicado el 6 de octubre de 2026. Consulta: 7 de octubre de 2026.
- Google AI for Developers: ficha técnica de EmbeddingGemma 2. Consulta: 7 de octubre de 2026.
- Google Developers Blog: guía técnica de EmbeddingGemma 2, 6 de octubre de 2026. Consulta: 7 de octubre de 2026.
- SiliconANGLE: cobertura independiente del lanzamiento, 6 de octubre de 2026. Consulta: 7 de octubre de 2026.


Deja una respuesta