Por Redacción Pangea IA · 28 de octubre de 2026
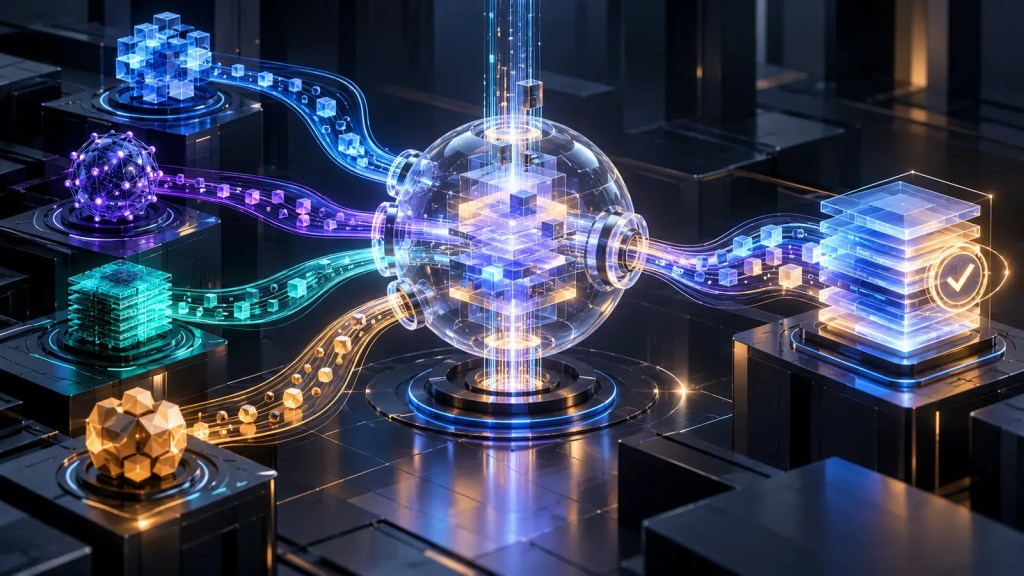
GitHub ha hecho disponible de forma general Copilot Fusion, un sistema que elige automáticamente qué modelos de inteligencia artificial deben intervenir en una tarea de programación y cómo coordinarlos. En lugar de obligar al usuario a decidir entre Claude, GPT u otros modelos antes de empezar, Fusion puede asignar uno para elaborar una solución y otro para revisarla, devolviendo una única respuesta.
La novedad, anunciada el 28 de octubre durante GitHub Universe 2026, está disponible en Visual Studio Code, Copilot CLI, la aplicación de GitHub Copilot y los entornos JetBrains. Llega a todos los planes de Copilot, siempre que el usuario tenga acceso a los modelos que el sistema necesita para ejecutar la tarea.
Qué cambia con Copilot Fusion
Hasta ahora, una decisión habitual al trabajar con asistentes de programación era escoger manualmente un modelo según el tipo de trabajo: uno rápido para preguntas sencillas, otro más costoso para depurar código complejo y un tercero para revisar resultados. Copilot Fusion convierte esa elección en una capa de orquestación.
GitHub explica que el sistema analiza las señales de cada petición —razonamiento, generación de código, depuración o uso de herramientas— y selecciona modelos y patrones de ejecución en tiempo real. También tiene en cuenta la disponibilidad de los servicios y procura conservar el modelo principal cuando el contexto almacenado en caché permite ahorrar coste.
La coordinación no significa que siempre participen varios modelos. En una petición sencilla puede bastar uno; en los niveles de esfuerzo superiores, Fusion puede generar un borrador con un modelo y encargar a otro una revisión especializada. El usuario ve una sola conversación, aunque por debajo se hayan ejecutado distintas etapas.
Una respuesta al exceso de modelos para programar
El lanzamiento reconoce un problema práctico: la oferta de modelos de código cambia demasiado rápido para que cada equipo pruebe continuamente todas las combinaciones. Pangea IA ya analizó alternativas abiertas como Nanbeige4.3-33B para agentes de programación, mientras que nuevos servicios compiten por controlar todo el flujo de desarrollo.
Para una pyme o un profesional autónomo, delegar la selección puede ahorrar tiempo de evaluación y reducir errores al usar un modelo inadecuado. Una reparación compleja podría recibir más razonamiento y revisión; una consulta rutinaria, una ruta más ligera. La contrapartida es perder parte de la previsibilidad sobre qué modelo interviene y cuánto consumirá cada petición.
El coste no desaparece: puede aumentar
GitHub no cobra una tarifa separada por Fusion, pero factura los modelos que utiliza. Si una tarea activa dos modelos, el consumo incluye ambos. La documentación advierte de que los niveles Fusion High y Fusion Max pueden gastar más créditos de IA que Standard precisamente porque permiten ejecuciones múltiples y revisiones adicionales.
Los usuarios de planes de pago disponen de un descuento del 30 % en el coste de los modelos usados por Fusion hasta el 30 de noviembre de 2026. Es una promoción temporal, no una rebaja permanente. Antes de adoptar el sistema para todo el equipo conviene medir el coste por tarea terminada, no solo el precio de una petición aislada.
Rendimiento prometedor, con pruebas todavía limitadas
Artificial Analysis probó la orquestación y la situó cerca del rendimiento de modelos de programación de primera línea con un coste inferior en determinadas tareas. VentureBeat recoge que Fusion se aproxima al resultado de Claude Opus 5.5 por alrededor de la mitad del coste por tarea en esa evaluación. Es una señal relevante, pero no demuestra que la ventaja se mantenga en todos los lenguajes, repositorios o flujos empresariales.
Los resultados dependen del conjunto de pruebas, los modelos disponibles y la estrategia de orquestación, que GitHub puede modificar con el tiempo. Cada empresa debería repetir la comparación con sus propios errores, pruebas, normas de estilo y requisitos de seguridad.
Qué riesgos deben vigilar los equipos
La documentación señala una limitación importante: si Fusion descarta un borrador, las modificaciones que ese borrador ya haya realizado en el espacio de trabajo no se deshacen automáticamente. Por tanto, la revisión de cambios y el control de versiones siguen siendo necesarios antes de aceptar o fusionar código.
Fusion tampoco sustituye a los subagentes ni los inicia por sí mismo. Es un enrutador y orquestador de modelos dentro de una tarea, mientras que los proyectos multiagente son otra función. Esta distinción importa porque el grado de autonomía, los permisos y el coste pueden ser diferentes.
GitHub también ha abierto una vista experimental para que Fusion seleccione modelos locales compatibles. Puede mejorar la privacidad o reducir dependencia de la nube, pero sigue en fase de prueba. La seguridad de agentes con permisos sobre repositorios continúa siendo un asunto propio, como muestra el análisis de Pangea IA sobre la vigilancia de agentes como riesgos internos.
GitHub amplía su apuesta por equipos de agentes
Copilot Fusion forma parte de una actualización más amplia. GitHub presentó Copilot Projects en vista previa para coordinar trabajo entre varios repositorios, continuidad de sesiones entre móvil, web, CLI y VS Code, y automatizaciones que pueden activarse por eventos o por horario. También declaró disponibles de forma general sus Agentic Workflows para tareas como clasificar incidencias, analizar fallos de integración continua o actualizar documentación.
El movimiento llega un día después de que Entire presentara una plataforma alternativa a GitHub orientada a agentes. La respuesta de GitHub no consiste en un único modelo mejor, sino en convertir su plataforma en el lugar donde varios modelos y agentes colaboran alrededor del código.
Qué significa para empresas y desarrolladores
Copilot Fusion puede simplificar el uso cotidiano de la IA para programar: el equipo define el objetivo y el sistema decide cuánta inteligencia necesita. Su utilidad será mayor si realmente reduce revisiones fallidas y tiempo hasta completar una tarea.
La decisión práctica no debería basarse solo en una clasificación. Los equipos deben comparar tres datos: calidad del código aceptado, coste total de los modelos y tiempo humano dedicado a revisar. Si Fusion mejora los tres, la orquestación será más valiosa que elegir manualmente el modelo de moda; si solo oculta un consumo mayor, la comodidad puede salir cara.
Fuentes
- GitHub Universe 2026: anuncios oficiales, 28 de octubre de 2026.
- Documentación oficial de GitHub Copilot Fusion, consultada el 28 de octubre de 2026.
- GitHub Changelog: disponibilidad general de Fusion, 28 de octubre de 2026.
- Artificial Analysis: evaluación de Copilot Fusion, 28 de octubre de 2026.
- VentureBeat: rendimiento y coste de Fusion, 28 de octubre de 2026.
- The Next Web: GitHub Universe y Copilot Fusion, 28 de octubre de 2026.
- El Español: GitHub refuerza Copilot con varios modelos, 28 de octubre de 2026.

Deja una respuesta