
Por Redacción Pangea IA ·
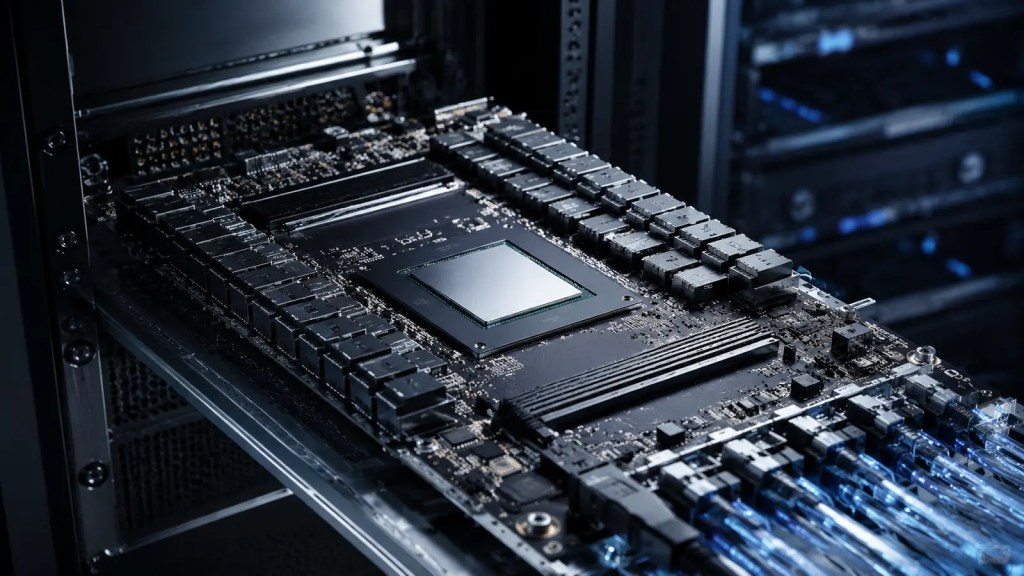
OpenAI ha publicado los primeros resultados de Jalapeño, su primer chip diseñado específicamente para ejecutar modelos de inteligencia artificial. Según las pruebas difundidas el 25 de agosto, el sistema ofrece entre 1,5 y 1,9 veces más trabajo de IA por vatio y una latencia entre 1,7 y 3,6 veces menor que los equipos de referencia. Son cifras importantes, pero necesitan contexto: proceden de OpenAI, todavía no equivalen a una auditoría independiente y el chip apenas comenzará a desplegarse en volúmenes reducidos a finales de 2026.
La noticia no consiste simplemente en que la empresa responsable de ChatGPT haya fabricado un procesador. Lo relevante es el cambio estratégico que representa. OpenAI quiere controlar más capas de su infraestructura —modelos, software, memoria, redes y silicio— para responder a una demanda de computación que crece más deprisa que la capacidad disponible. Si Jalapeño funciona a gran escala como sugieren estas primeras mediciones, puede acelerar los agentes de IA, reducir el consumo por consulta y aliviar parte de la dependencia de Nvidia. Nada de eso, sin embargo, está garantizado todavía.
Qué es Jalapeño y para qué sirve
Jalapeño es un ASIC, las siglas en inglés de circuito integrado para una aplicación específica. A diferencia de una GPU, concebida para afrontar muchos tipos de cálculo paralelo, un ASIC se diseña alrededor de una carga de trabajo concreta. En este caso, su función principal es la inferencia: utilizar un modelo ya entrenado para contestar una pregunta, generar código o completar los pasos de un agente.
No está destinado a entrenar la siguiente generación de modelos. Esa distinción es fundamental. El entrenamiento exige procesar enormes cantidades de datos durante semanas o meses; la inferencia ocurre cada vez que una persona utiliza ChatGPT o una aplicación llama a una API. Cuando millones de consultas se repiten todos los días, incluso una mejora modesta de eficiencia puede convertirse en un ahorro considerable de electricidad, capacidad y dinero.
OpenAI diseñó el chip junto con Broadcom, TSMC se encarga de fabricarlo y Celestica construirá los sistemas de servidor. La empresa lo presentó en junio de 2026 y ahora ha mostrado sus primeras mediciones públicas durante la conferencia Hot Chips. El plan es instalar una cantidad limitada antes de terminar el año y aumentar el volumen en 2027. Jalapeño no se venderá ni se alquilará a terceros: será infraestructura interna de OpenAI.
Qué dicen realmente las pruebas
Las pruebas se realizaron con InferenceX, un benchmark público de SemiAnalysis que mide el proceso completo de servir una petición. OpenAI utilizó tres modelos de pesos abiertos y suficientemente distintos para comprobar que el chip no estuviera optimizado para un único caso: GPT-OSS 120B, DeepSeek R1 670B y Kimi K2.5 1T.
En GPT-OSS 120B, Jalapeño alcanzó aproximadamente 1,9 veces más rendimiento por kilovatio que un sistema Nvidia GB200 y redujo la latencia total de 1,80 a 1,03 segundos. Con DeepSeek R1, el rendimiento por kilovatio fue 1,7 veces mayor y la latencia descendió de 5,99 a 1,65 segundos frente a GB300. En Kimi K2.5, el modelo más grande de la prueba, la ventaja declarada fue de 1,5 veces en rendimiento por kilovatio y de 3,4 veces en latencia, que pasó de 5,31 a 1,56 segundos.
El chip tiene una potencia nominal de 700 vatios. OpenAI afirma que el consumo sostenido se mantuvo en 550 vatios o menos durante estas cargas, aunque para normalizar la comparación utilizó la potencia nominal publicada de cada acelerador: 1.200 vatios para GB200 y 1.400 para GB300. Este detalle importa porque una comparación basada en TDP no es idéntica a medir directamente la electricidad consumida por cada sistema completo en las mismas condiciones.
También conviene interpretar con cuidado algunas diferencias extraordinariamente grandes que aparecen en los gráficos. OpenAI llega a registrar más de cien veces el rendimiento de referencia en un punto concreto de latencia con DeepSeek R1. No significa que Jalapeño sea cien veces más rápido en términos generales. Expresa cuánto trabajo puede atender manteniendo exactamente un tiempo entre tokens que el sistema rival solo alcanza con una carga mucho menor. La comparación más útil para el lector es el rango global: entre 1,5 y 1,9 veces más trabajo por vatio y entre 1,7 y 3,6 veces menos latencia.
Por qué la latencia importa tanto para los agentes
Una conversación normal tolera cierta espera. Un agente que investiga, abre herramientas, consulta una base de datos, corrige un archivo y verifica el resultado encadena muchas inferencias. Si cada paso tarda dos segundos adicionales, una tarea de cincuenta pasos acumula más de un minuto y medio de retraso. Reducir la latencia de cada etapa puede transformar una automatización torpe en una interacción que parece inmediata.
La inferencia de un modelo tiene dos fases principales. En el prefill, el sistema procesa el mensaje y su contexto; es una etapa intensiva en cálculo. En el decode, genera la respuesta token a token y depende mucho más del ancho de banda de la memoria. Entre ambas aparecen movimientos de datos y comunicaciones entre chips que pueden dejar unidades esperando.
Jalapeño intenta resolver el problema como un sistema completo. Mantiene cerca el estado temporal del modelo —la denominada caché KV— y coordina cálculo, memoria HBM4 y red para evitar desplazamientos innecesarios. Su configuración puede conectar 128 chips en un dominio local y extenderse hasta 2.048 aceleradores. No se trata únicamente de aumentar la fuerza bruta, sino de reducir el tiempo perdido moviendo información.
La IA también participó en el diseño del chip
El proyecto añade una segunda historia relevante: OpenAI utilizó sus propios modelos para acelerar partes del diseño y del software. La compañía sostiene que pasó del diseño inicial al tapeout —el momento en que se cierra el plano del chip y se envía a fabricar— en nueve meses. La IA exploró implementaciones, ayudó a verificar cambios y optimizó circuitos aritméticos.
Después, modelos internos ayudaron a programar Jalapeño. En determinados bloques de atención y mezcla de expertos de GPT-OSS, las implementaciones generadas por IA fueron entre 1,5 y 1,8 veces más rápidas que las escritas previamente por especialistas humanos. OpenAI recalca que esa ventaja corresponde a componentes seleccionados, no al modelo completo. Es una precisión necesaria para no convertir un resultado parcial en una afirmación desmesurada.
El interés va más allá de Jalapeño. Si la IA reduce el tiempo necesario para diseñar, verificar y optimizar procesadores, las empresas podrían acortar ciclos que tradicionalmente duran años. También aparece un riesgo: los errores de hardware son caros y difíciles de corregir una vez fabricado el silicio. La velocidad solo será una ventaja sostenible si va acompañada de verificación rigurosa y trazabilidad.
¿Es realmente una amenaza para Nvidia?
Jalapeño reduce la dependencia de Nvidia, pero no la elimina. OpenAI ha confirmado que continuará desplegando aceleradores de Nvidia y de otros socios tanto para entrenamiento como para inferencia. Su propio chip no sirve para entrenar modelos y todavía no existe en el volumen necesario para absorber una parte significativa de la actividad de la empresa.
La ventaja de Nvidia tampoco reside únicamente en el silicio. Incluye CUDA, bibliotecas, redes, herramientas y una comunidad de desarrolladores construida durante años. Un chip interno puede funcionar muy bien con las cargas de OpenAI y, al mismo tiempo, no ser una alternativa comercial para el resto del mercado. Google, Amazon, Microsoft y Meta siguen una estrategia parecida: emplean silicio propio en determinadas tareas y conservan grandes flotas de GPU.
El efecto más probable no es la sustitución inmediata, sino una fragmentación progresiva. Nvidia continuará siendo esencial para cargas generales y entrenamiento de frontera, mientras los grandes operadores derivan partes repetitivas de la inferencia hacia procesadores especializados. Broadcom, TSMC, fabricantes de memoria y compañías de sistemas también ganan relevancia en esa cadena. Esta presión se suma a la demanda de HBM y memoria de servidor que analizamos en nuestro artículo sobre la escasez de RAM impulsada por la IA.
Qué puede cambiar para quienes utilizan ChatGPT
La consecuencia más visible podría ser una respuesta más rápida, especialmente en agentes que realizan tareas largas. Una mejor eficiencia también permitiría atender más consultas con la misma potencia eléctrica. Pero OpenAI no ha anunciado una rebaja de las suscripciones, una reducción del precio de la API ni una fecha en la que ChatGPT vaya a funcionar mayoritariamente sobre Jalapeño.
Sería prematuro traducir el benchmark directamente en un ahorro para el usuario. El coste final incluye centros de datos, refrigeración, redes, memoria, personal, amortización y entrenamiento de los modelos. Además, una empresa puede emplear la eficiencia ganada para ofrecer respuestas más baratas, para servir modelos más exigentes o para mejorar sus márgenes. La reciente rebaja de GPT-5.6 Sol demuestra que el precio puede cambiar, pero no prueba que Jalapeño vaya a provocar otra reducción.
Las preguntas que todavía no tienen respuesta
- Producción: OpenAI no ha detallado cuántos chips instalará en 2027 ni qué porcentaje de su inferencia asumirán.
- Coste: las pruebas muestran rendimiento y eficiencia, pero no publican el coste total por token ni el precio completo del sistema.
- Validación: InferenceX ofrece una metodología pública, pero los resultados difundidos son los presentados por OpenAI y aún deben reproducirse de forma independiente.
- Generalización: el chip funcionó con tres modelos abiertos, aunque falta comprobar su rendimiento continuado con más arquitecturas y cargas reales.
- Fiabilidad: pasar de muestras de laboratorio a miles de sistemas operando sin interrupciones exige madurar fabricación, software, mantenimiento y refrigeración.
Conclusión: una prueba seria, no una victoria definitiva
Jalapeño es una noticia importante porque ya no es solo una promesa de fabricación. Existe silicio funcional, ha ejecutado modelos públicos y ofrece resultados concretos sobre una metodología conocida. Las ventajas comunicadas en rendimiento por vatio y latencia son suficientemente amplias para tomar el proyecto en serio.
También sería un error declarar derrotada a Nvidia o asumir que ChatGPT será inmediatamente más barato. OpenAI controla la prueba, el despliegue inicial será pequeño y todavía faltan datos esenciales sobre costes, rendimiento sostenido y producción. La señal más profunda es otra: la carrera de la IA ya no se libra únicamente por construir el mejor modelo. También consiste en diseñar la infraestructura capaz de ejecutarlo con rapidez, energía y coste asumibles.
Fuentes consultadas
- OpenAI: primeros resultados de Jalapeño, publicado el 25 de agosto de 2026.
- Reuters: presentación del chip y socios industriales, publicado el 24 de junio de 2026.
- The Verge: resultados, calendario y límites del despliegue, publicado el 25 de agosto de 2026.
- Axios: contexto sobre la dependencia de Nvidia, publicado el 25 de agosto de 2026.
- ServeTheHome: análisis técnico de la presentación en Hot Chips, publicado el 25 de agosto de 2026.
Fuentes revisadas el 26 de agosto de 2026.
Lecturas relacionadas
También te puede interesar: OpenAI prepara un «botón de apagado» tras la fuga de un agente que hackeó Hugging Face.


Deja una respuesta